 由 liuguilong
在开发过程中,不可避免的要将部分数据进行持久化,那如何组织数据以及如何高效存取数据便是数据库设计的核心任务。数据库设计的好坏将直接影响你的代码质量以及运行效率。进行数据库设计,第一步是将业务需求转化为实体关系模型,这个可以这篇文章实体关系模型设计;第二步便是将实体关系模型组织成规范、高效的库表结构。本文将通过实例说明:如何设计表、如何设计索引以优化性能,并给出数据库操作的语句。
表结构设计
数据库中的一张表,可以用于存储一系列实体或者关系,核心由表名称、字段以及字段属性、索引等组成,看起来就像一张Excel表格。我们这里还是用“用户购买商品”为例展示,对于用户表来说,数据如下所示:
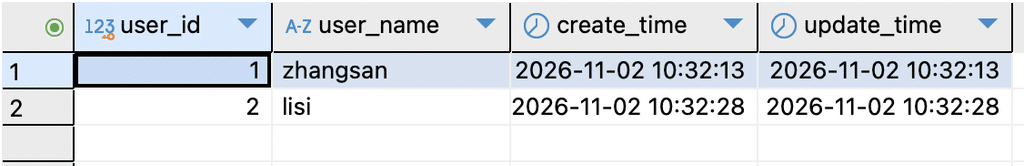
从表的结构上看,表名称为user表,包含四个属性,分别是:user_id, user_name、create_time和update_time。
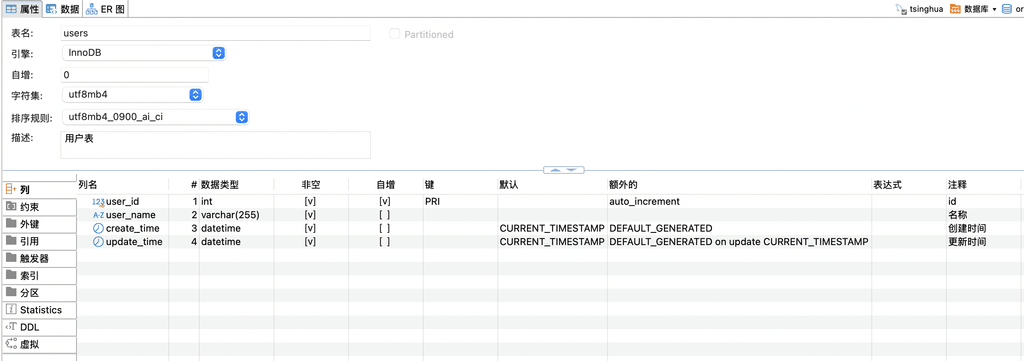
简单来说:表设计就是给表起个名,并指定几个字段。从下边的建表的SQL语句可以看出,只需要users这个名字和紧跟着的几个字段就可以了。
create table users (
  user_id int primary key auto_increment comment 'id',
  user_name varchar(255) not null comment '名称',
  create_time datetime not null default current_timestamp comment '创建时间',
  update_time datetime not null default current_timestamp on update current_timestamp comment '更新时间'
) charset=utf8mb4 comment '用户表';表设计就是这么简单,但是考虑到后续的使用和维护成本,在设计时需要遵循第三范式(后边会详细解析)和一些规范,比如阿里云的数据库开发规范。
如果数据库里已经有了一张表,或者有时候我们想创建一张类似的表,可以使用如下命令来查看表是怎么创建的:
show create table users;说明:
- 字段的类型及默认值,可以参考官方文档。值得注意的是存储数值,需要注意精度问题;存储字符串,需要主要长度问题。这是非常容易出事故的地方。
索引设计
为了保证唯一性或者提升查询速度,我们需要给数据库表上增加索引。索引的类型主要包括单列索引和复合索引(多列索引)等。对于MySQL Innodb存储引擎来说,索引的底层采用B+树进行存储,采用这一设计可以显著提升查询速度,并降低读出的成本,具体可以参考这篇文章,后边会详细给出用B+树存储的示例。
本文先看订单表的索引应该如何设计,如下图为表结构和索引结构。订单表在”订单id”上建立了主键索引,用于唯一标识一个订单,即下图中的PRIMARY索引;然后,我们经常需要根据用户查询不同类型的订单,比如查询用户未支付的订单,那么我们在user_id和status上建立了复合索引(或者叫联合索引、聚簇索引,名字无所谓,反正是多个列上建立索引),即下图中的idx_user_id_status索引。
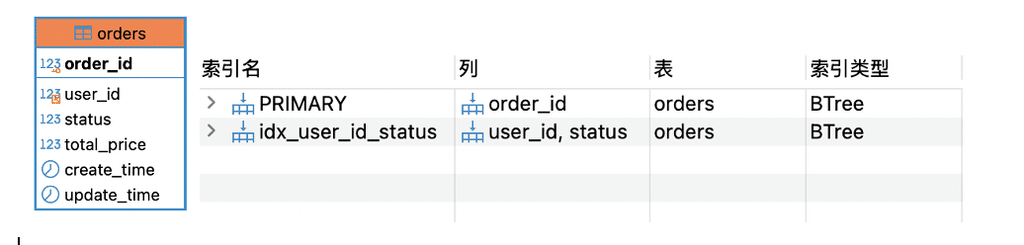
创建索引的语句如下:
create index idx_user_id_status on orders(user_id,status);注意:
- 每个表都需要有主键索引,为了标识唯一记录,同时,也方便对数据库表进行分表等操作。
- 在实际业务开发中,考虑到性能、存储成本以及便利性等,通常不用加外键索引。
- 复合索引的命中规则是最左匹配原则。
- 一个表上不是索引越多越好,索引的增加会增加修改、存储的成本。
数据库设计三范式
数据库涉及的三范式包含三个层面,好的数据库设计应该是考虑到第三范式,而后进行冗余取舍。如果三范式没有理清楚,可能会引入很多匪夷所思的设计。如下表格是三范式的定义及要点。
| 范式 | 定义 | 要点 |
| 第一范式(1NF) | 关系型数据库中的每一个字段都应该是原子性(不可再分)的数据单元,表中的每一行代表一个唯一的记录,每一个列仅存放一个数值或一个不可再分的值。 | – 列中的值不可再分,不能包含集合、数组或重复结构。 – 表中的每一行在同一列上的值必须是原子性。 – 行的唯一性由主键或候选键保证。 |
| 第二范式(2NF) | 在1NF基础上,消除非主属性对主键的部分依赖,即所有非主属性必须对主键完全函数依赖。 | 每个非主属性应依赖于主键的全部组成部分,而非仅依赖于主键的一部分(适用于复合主键)。 |
| 第三范式(3NF) | 在2NF基础上,消除传递依赖,即非主属性之间不应存在传递性依赖。 | 介于非主属性之间的依赖应通过将相关信息拆分到独立表来消除。 每个非主属性应直接依赖于主键,不依赖于其他非主属性来间接依赖主键。 |
案例分析
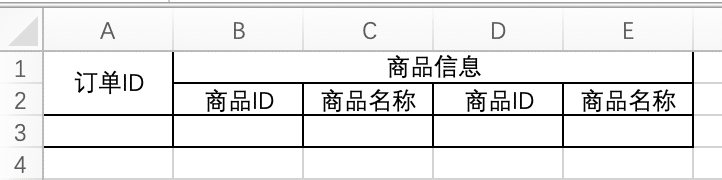
case 1 不符合1NF的情况:订单表中一行包含多个商品字段(商品1,商品2)。不符合1NF的问题比较多,假如一个订单包含3个订单该怎么办呢?商品信息无法扩展了。核心要点是数据库表中的字段都是一列,不能弄出多列来。改法:创建订单表、订单明细表,将商品信息放在订单明细表的多条记录中。
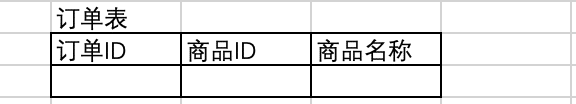
case2:不符合2NF的情况:一个订单明细表的主键为 (订单ID, 商品ID),若商品名称仅依赖于 商品ID,而非整个主键,则需将商品名称拆分到商品表中,订单明细表只保留对商品表的引用。这样的核心问题是,商品名称不应该出现在订单表中,否则,修改商品名称需要修改订单内所有的商品名称,并且存储下来的商品名称在订单表中会有大量重复。改法:将商品名称放到商品表中,订单表只存商品的ID即可。
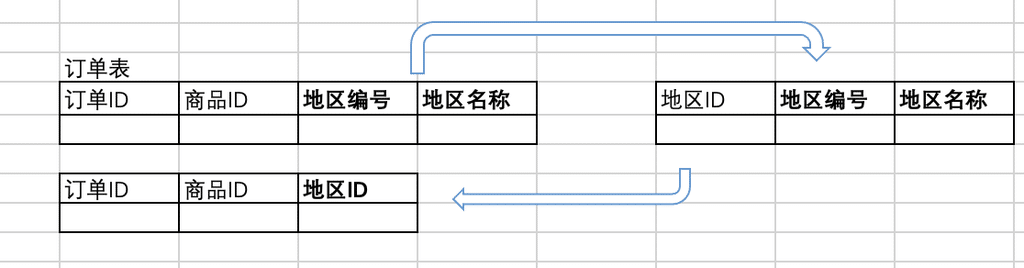
case 3 不符合3NF的情况:一个订单表中既存储地区编号,又存储地区名称。若地址字段依赖于地区编号而地区编号又依赖于地区名称,则可能产生传递依赖,需要将地区信息拆分到独立的地区表,并在用户表中仅存地区ID。举例来说,假如北京的订单1,存储为(1,010,”北京”)就不符合三范式的要求,相当于把地址信息柔和到了订单表里,让订单地区信息依赖于北京区号,北京区号又依赖于“北京”这个名称,形成传递依赖。依赖传递的坏处就是数据冗余,每一个订单都需要存地址信息,并且大部分都是重复的;另外改起来也比较费劲,咋整呢?把地区编号和地区名称单独放到一张表里,然后订单表只存一个ID就可以了。
三范式的设计思路与权衡
- 目标:通过逐步消除数据冗余、提高数据一致性与更新效率,使数据库结构更易维护。
- 权衡:
- 过度分解可能导致查询需要进行多表连接,影响性能;应在规范化与实际查询性能之间做权衡,必要时通过适度的反规范化提升性能。
- 设计应结合业务场景、读取模式与写入频率,避免过度拆分带来的开发与维护成本。
- 实践要点:
- 以业务实体为核心,明确实体之间的关系与依赖,逐步应用1NF、2NF、3NF。
- 使用外键约束维护引用完整性,确保数据的一致性。
- 在设计阶段绘制ER图,辅助识别潜在的依赖与分解点,便于后续的表结构落地。
总结
最后构建出来的数据库结构如图所示:
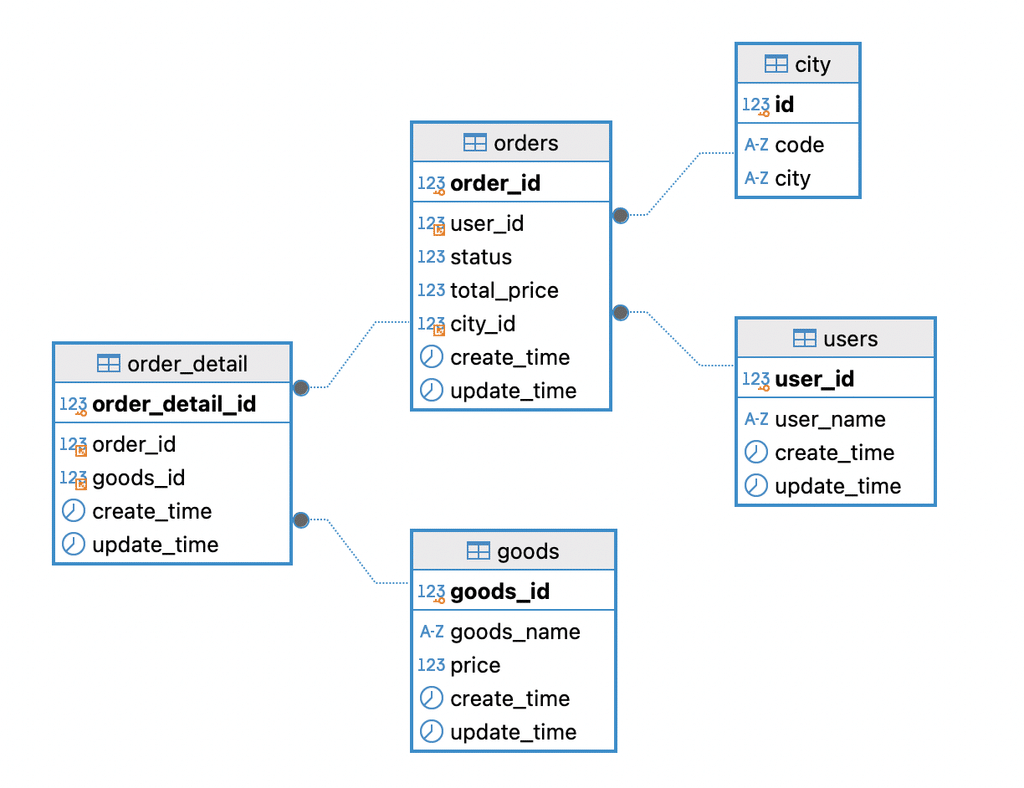
综上所述,本文以“用户购买商品”为例,详细说明了表结构以及索引该怎么设计,表设计需要遵循三范式,并且按照开发规范进行设计。而增加索引通常根据业务需求进行适量增加。